Traduction française de l’article publié en 2021. Les faits, données et références correspondent à la publication originale. Les illustrations et documents sources sont conservés dans leur langue d’origine.
Voici la deuxième partie d’une série de trois sur la façon dont la réglementation de l’IA peut aider à résoudre des problèmes plus profonds — partie I. Et voici la partie III : Concevoir pour l’humain dans la boucle.
Les examens font partie des nombreuses choses bouleversées par la pandémie l’an dernier. Au Royaume-Uni, les A-levels sont décisifs pour beaucoup d’élèves, dont l’admission à l’université dépend des résultats. Ils couronnent le secondaire et influencent le parcours pendant des années. Comme le confirmeront les élèves, rien n’est certain tant que cette dernière occasion de faire ses preuves n’est pas passée et que les résultats ne sont pas arrivés. Cet examen permet de rattraper des devoirs manqués ou des journées de paresse; il peut aussi ne pas refléter un travail assidu. Mais cela reste entre leurs mains — du moins jusqu’à l’an dernier. Les examens ont été reportés indéfiniment et les résultats confiés à un algorithme.
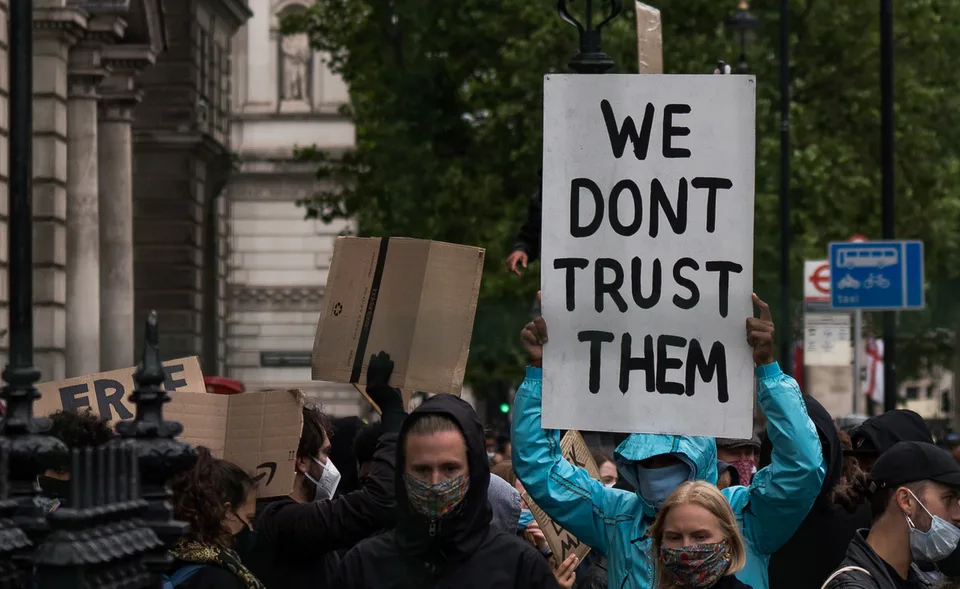
Ofqual, l’organisme public qui réglemente les examens en Angleterre, a choisi un algorithme qui a abaissé les notes de près de 40 % des élèves. Il leur a retiré leur dernière chance de faire leurs preuves cette année-là et, pour certains, leur place à l’université. Les élèves des milieux défavorisés ont été particulièrement touchés, probablement victimes de biais inscrits dans des données reflétant l’écart historique entre riches et pauvres. Ils ne pouvaient plus déjouer cette tendance par leurs efforts de fin d’année. Ces élèves en progression étaient, par définition, des exceptions; on les a plutôt enfermés dans des distributions et classements automatisés bien ordonnés, sans tenir compte de leurs efforts individuels.
Une grande partie de la vie moderne a été façonnée pour s’adapter à des machines rigides. Leur utilisation a largement amélioré la condition humaine, mais certaines des adaptations qu’elles nous imposent ont un prix. Cela ne vient pas de la volonté des machines. Cela vient des limites de notre ingénierie, et plus encore de leurs concepteurs et de leurs propriétaires, qui font des machines une représentation abstraite de leur pouvoir. Ils rencontrent peu de contrepoids, voire aucun.
Pourquoi un choix manifestement mauvais n’a-t-il pas été arrêté avant sa mise en œuvre? Gavin Williamson avait pourtant été averti, très publiquement, des erreurs précises qu’entraînerait le recours à l’algorithme. Un parent avait même prédit exactement le taux d’erreur avant le déploiement. Ces erreurs traduisent au minimum une dépendance négligente aux algorithmes ou, pire, leur utilisation comme boucs émissaires pour perpétuer des biais injustes.
Deux mois après le fiasco des A-levels, juste avant les fêtes aux États-Unis, les dirigeants de l’hôpital Stanford ont eux aussi affronté une foule en colère. Un système automatisé avait donné la priorité vaccinale contre la COVID-19 à des administrateurs et à des médecins en télétravail, avant le personnel de première ligne. Au Royaume-Uni comme à Stanford, le slogan le plus rapporté était « fuck the algorithm » — une formule que nous entendrons probablement de plus en plus.
Comme je le disais dans la partie I : le seul contrepoids est l’intervention gouvernementale, influencée par l’action citoyenne. Cet article examinait le règlement européen sur l’IA, ou AIA, une étape gouvernementale majeure. Rappelons qu’il s’agit de la plus importante réglementation de l’IA proposée à ce jour. Ses normes seront précisées au cours des trois ou quatre prochaines années et définiront probablement la référence dans une grande partie du monde, par l’« effet Bruxelles ». Pour l’IA, cela peut sembler précoce; pour le numérique, bien tardif. Dans les deux cas, c’est le fruit des appels constants et persistants de la société civile à encadrer une technologie de plus en plus puissante.
Contester bien plus que les algorithmes
Ces problèmes ne sont pas seulement techniques. Ils touchent notre pouvoir d’agir en tant qu’humains face aux erreurs possibles des décideurs et des systèmes dans lesquels nous vivons. Beaucoup d’élèves britanniques descendus dans la rue n’avaient même pas vu leur note abaissée. Des élèves échouent chaque année à des examens décisifs. Ils ne manifestaient pas contre de mauvaises notes : ils défendaient leur capacité à faire leurs preuves.
Cette perte de pouvoir d’agir s’est accumulée au fil du temps. Les technologies de l’information nous ont apporté de grandes libertés économiques et politiques. Mais nous y avons aussi inscrit l’hypothèse — ou l’objectif — d’un utilisateur passif. Nous avons créé de nombreux produits qui fonctionnent comme des «artefacts cognitifs concurrentiels[1]», selon l’expression de David Krakauer, président du Santa Fe Institute. Ces outils se substituent à notre réflexion au lieu de la soutenir et de l’élargir. C’est la différence entre un GPS qui améliore notre capacité à nous orienter et un GPS qui la détériore. Au nom de la « convivialité », nous avons limité le choix et la personnalisation pour masquer et protéger des systèmes sous-jacents complexes, rigides et fragiles.
La capacité de l’IA à apprendre des régularités dans de grandes quantités d’informations, structurées comme non structurées, apporte beaucoup de souplesse aux logiciels. Elle nous donne une occasion précieuse de parcourir toute l’information disponible, de lui donner du sens et d’en adapter la synthèse à nos besoins. Pourtant, la conception de ces outils comporte un vrai danger : automatiser une trop grande part de notre propre pensée critique. Une fois la confiance installée, elle peut devenir excessive et nous faire perdre de vue nos valeurs et nos objectifs. Nous céderions alors davantage de notre pouvoir d’agir aux propriétaires des machines.
Cette souplesse s’accompagne aussi d’une opacité accrue du fonctionnement précis des machines. Face à un algorithme présenté comme omniscient et tout-puissant, dont les décisions sont incompréhensibles, nous avons peu de prises pour nous opposer et contester.
Les quelques contrôles dont nous disposons viennent justement des exigences gouvernementales et de la pression publique. Mais les principes de conception « conviviale » les enfouissent dans plusieurs couches de paramètres, et ils ne modifient l’expérience qu’à la marge : voulez-vous voir cette publicité ou une autre?
Notre environnement technologique a implicitement réduit le pouvoir d’agir individuel au profit de la valeur extraite des parties prenantes. Les plateformes orientent nos comportements et les capteurs nous surveillent, alors que nous avons peu de moyens d’ajuster notre expérience. Le choix se résume à jouer le jeu ou à s’en retirer complètement.
L’IA nous donne l’occasion de renverser la logique
Paradoxalement, je crois que ce moment de l’IA permet de renverser la logique : adapter les machines à nous et reprendre la main. L’IA n’est ni toute-puissante ni omnisciente, mais elle n’est pas non plus une machine rigide. Avec le bon contexte, elle peut apprendre et s’adapter à bien plus de nuances. Des objectifs nuancés lui permettent de servir des besoins très spécialisés. L’explosion des capacités logicielles grâce à l’apprentissage profond pourrait entraîner une explosion encore plus grande d’applications et d’expériences numériques adaptées aux vies que nous voulons mener. Les ingénieurs ont toujours des systèmes labyrinthiques à gérer, mais leur fragilité ne justifie plus de la même façon de limiter la personnalisation par les utilisateurs.
Aujourd’hui, ces objectifs sont largement définis et contrôlés par un très petit nombre de personnes, ce qui limite l’efficacité de l’IA. Il lui manque les contextes locaux et personnels qui pourraient lui permettre d’accomplir incroyablement plus que ce que nous faisons déjà avec les logiciels. Réaliser le potentiel promis par cette génération de logiciels — et même par la précédente — dépend d’une collaboration dynamique avec les utilisateurs. Pour l’instant, ceux-ci n’ont que peu ou pas de pouvoir d’agir dans cette collaboration.
Nous programmons déjà nos expériences numériques par nos comportements. Si cette programmation devenait explicite et transparente, les capacités logicielles pourraient réellement se démocratiser. Au-delà d’un mot séduisant, cette démocratisation permettrait une adaptation juste et équitable aux contextes locaux, impossible avec des systèmes rigides et centralisés.
Les risques de l’IA peuvent aussi devenir des occasions. Lorsqu’elle détecte un biais dans les données, demandons-nous d’où il vient. Souvent, elle ne fait que repérer et rendre visibles les biais de nos systèmes sociaux. Les automatiser sans précaution est un grave problème qu’il faut prévenir, mais ne perdons pas l’occasion d’examiner les problèmes de fond ainsi révélés. Résoudre les risques technologiques exige de traiter les problèmes sociaux préexistants qu’ils amplifient. À l’échelle de l’IA, cela demande encore une compréhension personnalisée et contextuelle.
Résoudre les problèmes sociaux de fond et appliquer la technologie démocratiquement : ces possibilités ne se réaliseront que par une réglementation, une technologie et une participation citoyenne éclairées par la dynamique technique et par les droits et valeurs humains universels. Le nouveau règlement européen sur l’IA nous en donne l’occasion. Il peut nous aider à repenser et à réparer notre relation à la technologie. Mais la société civile doit connaître les points sur lesquels elle peut agir dans les technologies d’IA. Sa participation sera nécessaire pour maintenir la pression en faveur de changements réels et concrets, sans jeter des outils capables de faire beaucoup de bien. Elle sera plus encore nécessaire pour bâtir les bons systèmes, qui comprennent les contextes et les besoins locaux. Si nous jouons bien nos cartes, nous pourrons réparer bien davantage que notre seule relation à la technologie.
Le problème est très difficile, encore aggravé par cette énigme : comment agir sur des machines dont on ne comprend pas les décisions, et empêcher les acteurs malveillants d’en abuser? Les appels croissants à tout démanteler n’ont rien de surprenant, pas plus que les compromis de la majorité en faveur de la commodité plutôt que des droits. Il faut d’abord convaincre le public qu’une bonne gouvernance est possible, qu’on peut prévenir les préjudices graves et concevoir de meilleures applications. Voyons comment l’AIA pourrait au moins détecter et sanctionner les systèmes algorithmiques courants[1] mal conçus, à partir de l’exemple des A-levels.
La réglementation peut-elle vraiment repérer les mauvais algorithmes?
Devant un tribunal, prouver l’intention est difficile. Nous ne pouvons pas entrer dans la tête d’une personne pour connaître ses pensées. Les circonstances et les comportements permettent des inférences, mais la dissonance cognitive suggère que la personne elle-même ne sait pas toujours ce qui l’a motivée. Avec l’IA, il n’y a pas d’intention à prouver. Nous ne pouvons qu’examiner pragmatiquement les entrées et les résultats, ainsi que le système qui entoure l’algorithme, pour scruter toutes les influences possibles et trouver la cause du problème.
Un algorithme d’apprentissage repère des régularités dans les données pour faire des prévisions. Il peut aussi être relié à un système de décision poursuivant un résultat plus large. Nous, humains, fixons les objectifs du système, qui déterminent ensuite si les données choisies sont appropriées et si le résultat global correspond à nos attentes. La conception comporte des hypothèses implicites, et les algorithmes sont eux-mêmes « conçus » par les données, qui peuvent contenir des biais. Lorsque les systèmes apprennent aussi de leur utilisation et de leur environnement, tenir compte de toutes les entrées devient très difficile.
L’AIA impose des objectifs à certains types de systèmes, établissant ainsi des principes universels pour reconnaître un mauvais système d’IA. Il désigne explicitement la notation des examens comme un usage à haut risque soumis à des obligations strictes. Ofqual a lamentablement échoué à les respecter.
L’algorithme britannique était peu sophistiqué : ce n’était même pas un algorithme d’apprentissage, mais un ensemble de règles ajustant les notes à une distribution statistique. Les données des cohortes et des écoles des trois années précédentes servaient à établir une distribution, comme une courbe en cloche. Les enseignants devaient proposer une note par élève et classer toute la classe, sans ex æquo. Le classement ajustait ensuite les notes à la courbe. Cette simplicité facilite l’analyse, mais un algorithme plus sophistiqué aurait pu le remplacer tout aussi facilement.
Les obligations
Les sept principes d’une IA digne de confiance constituent les objectifs imposés par l’AIA : action humaine et contrôle humain; robustesse technique et sécurité; vie privée et gouvernance des données; transparence; diversité, non-discrimination et équité; bien-être environnemental et sociétal; responsabilité. Issus de principes techniques et des droits de la personne, ils doivent se traduire dans la technologie grâce aux obligations suivantes.
Des données de grande qualité pour minimiser les risques et les résultats discriminatoires. Les données étaient mal adaptées. Les élèves subissaient les performances des cohortes antérieures. Une école peut s’améliorer en trois ans, mais ses élèves étaient contraints à une année « stable ». Leurs réalisations individuelles étaient ignorées, y compris les prévisions de leurs enseignants. L’interdiction des ex æquo obligeait souvent les enseignants à décider arbitrairement qui était « meilleur », ouvrant la porte aux biais et aux injustices. La courbe en cloche imposait elle-même des résultats discriminatoires.
Un niveau élevé de robustesse, de sécurité et d’exactitude. Les classements des enseignants n’avaient jamais été enregistrés auparavant. Impossible, donc, de les comparer à des classements antérieurs ou de vérifier si le résultat global était raisonnable. Sans données suffisamment fiables ni point de comparaison historique, on ne pouvait pas tester sérieusement l’exactitude du système.
Des informations claires et suffisantes pour l’utilisateur. Comme dans la plupart des systèmes, il existe plusieurs catégories d’utilisateurs. Ofqual n’a publié les détails de l’algorithme qu’après les résultats. Les enseignants ignoraient donc l’usage de leurs classements, et les élèves, les écoles et la société ne savaient pas comment fonctionnerait ce système. Une fois ses défauts révélés, de nombreuses universités ont écarté les résultats, sans parler de l’ampleur des manifestations.
Une documentation détaillée du système et de sa finalité pour permettre aux autorités d’évaluer sa conformité. On ne sait pas davantage si les administrateurs et les responsables politiques avaient été informés. L’absence apparente de recours et les effets clairement discriminatoires ont peut-être même enfreint la loi britannique. Ignorer les particularités individuelles hors de la distribution statistique contredisait aussi le mandat d’Ofqual : offrir une notation donnant une « indication fiable des connaissances, des compétences et de la compréhension de l’élève ».
Des systèmes adéquats d’évaluation et d’atténuation des risques. Fait intéressant, la Royal Statistical Society (RSS) avait proposé d’aider Ofqual à créer un algorithme équitable. Elle a retiré son offre lorsqu’on lui a demandé de signer un accord de confidentialité qui aurait gardé le système secret. La RSS l’a signalé publiquement , puis a relevé les occasions manquées de traiter diverses incertitudes, comme le classement des élèves intermédiaires ou la variabilité des trois années de référence. Quant à l’atténuation, elle n’a été envisagée qu’après l’indignation publique.
Des mesures appropriées de contrôle humain pour réduire les risques. Environ dix jours avant le fiasco d’Ofqual, une approche algorithmique comparable avait été appliquée en Écosse par l’autorité scolaire locale. Le résultat était clair : une grande proportion d’élèves voyait sa note abaissée, provoquant l’indignation. L’Angleterre a annoncé que les écoles, mais pas les élèves, pourraient contester certains résultats. Au-delà de cela, rien ne semble avoir été fait pour corriger les résultats réels de l’algorithme et prévenir une nouvelle colère.
Consigner les activités pour assurer la traçabilité des résultats? Dans ce cas, l’algorithme était simple à l’excès, ce qui permettait de repérer facilement où et comment les choses avaient mal tourné. Ces exigences sont utiles et assez solides pour évoluer avec des algorithmes plus complexes. Mais la traçabilité devient essentielle lorsque les systèmes se généralisent et apprennent d’un nombre bien plus grand d’entrées. Idéalement, les autres exigences empêchent le déploiement d’un système défectueux, pour que les journaux d’activité ne soient pas le seul garde-fou.
Ces obligations servent surtout à prévenir la violation des sept principes. Le problème tient donc moins aux « mauvais algorithmes » qu’à leurs usages irresponsables. Les mathématiques n’étaient pas nécessairement mauvaises : l’algorithme britannique appartenait à un système très mal conçu. D’autres outils, humains et informatiques, auraient pu produire un résultat mieux adapté aux objectifs de la société. Soutenir activement ces principes demande une démarche plus proactive.
Renverser la logique
Je précise d’abord que je ne suis pas spécialiste de l’éducation : les personnes qui connaissent bien ce domaine seront les mieux placées pour en repérer les véritables possibilités. Mon objectif est de montrer comment nous pourrions tirer parti de la dynamique de la technologie pour l’adapter à la société, et utiliser ses risques pour poser des questions plus profondes sur nos institutions et notre contrat social. C’est ce que j’entends par renverser la logique.
Déployer des systèmes comme l’algorithme britannique devient plus facile, et ces systèmes peuvent intégrer davantage de données et de complexité. Cela semble positif : des algorithmes plus exacts devraient poser moins de problèmes. Mais sans esprit critique, nous ne ferons qu’enraciner davantage les maux de notre société.
Adapter la technologie à la société et interroger ses problèmes sont deux possibilités liées, qui se contraignent mutuellement. La souplesse des outils devrait ouvrir nos systèmes aux contributions de davantage de parties prenantes. La plupart ont été conçus comme des compromis entre capacités techniques et objectifs. Les examens servent, dans des systèmes algorithmiques, à attribuer rôles et possibilités et à planifier la société, en retirant presque par définition une part de capacité d’agir. Ce n’est pas entièrement mauvais : le paradoxe du choix est réel, et réduire les options contribue à la cohésion sociale à grande échelle. Mais, au niveau de la planification sociale, les décideurs ne peuvent pas intégrer les notes de cours, recommandations, activités parascolaires et déclarations personnelles pour dresser un portrait individuel nuancé. Même si l’IA peut commencer à intégrer ces informations, nous ne devrions pas simplement la brancher sur un système conçu autour d’anciennes limites.
Une autre possibilité serait de partir de ces outils pour modéliser nos systèmes actuels sans aller jusqu’à les automatiser. On critique souvent les algorithmes parce qu’ils amplifient les biais. Séparés de la décision automatisée, ils pourraient plutôt révéler des problèmes jusque-là difficiles à démontrer clairement.
Organiser des examens pendant une pandémie était une situation sans précédent et sans solution simple. Le résultat illustre lui-même l’opacité des décisions d’un ministère. Une participation accrue à la recherche de solutions aurait pu largement prévenir la crise. Un processus ouvert aurait impliqué les élèves, favorisé leur adhésion et produit des résultats plus justes auxquels ils auraient cru. Il leur aurait aussi appris à participer et à défendre leurs intérêts, surtout dans un monde transformé par les algorithmes.[2] Associer les enseignants et des institutions comme la RSS à un processus ouvert permet de saisir cette occasion de résoudre les problèmes qui dépassent la technologie, sans écarter au passage des options utiles.
Avec des objectifs communs et des contributions expertes, nous pourrions mieux utiliser les outils disponibles. Administrateurs comme enseignants devraient vouloir prendre de meilleures décisions, avec de bonnes données et davantage de nuances.
S’attaquer aux problèmes de fond
Ces conversations peuvent avoir lieu avant ou après les préjudices. Idéalement avant, mais la nature humaine fait qu’il n’en sera souvent pas ainsi. Des lignes rouges importantes sont tracées, par exemple pour les armes autonomes et la manipulation des jeunes, mais les nouvelles normes de gouvernance ne seront pas parfaites d’emblée. Il faut être prêts à tirer les leçons de ces épisodes pour dénoncer plus tôt les usages irresponsables et profiter de la volonté d’agir pour apporter des corrections de fond. Cette expérience devrait ouvrir davantage la discussion sur notre capacité d’agir et sur la légalité même de telles décisions automatisées. Gavin Williamson semble au moins avoir compris qu’il fallaitéviter de reproduire la décision algorithmique cet été, au profit d’évaluations par les enseignants, d’une formation pour les rendre plus équitables et d’un processus de recours « robuste ». Pourtant, beaucoup de problèmes subsistent sous la pression de la COVID.
J’espère que nous ne rejetterons pas complètement les outils algorithmiques. Leurs mauvais usages tuent l’optimisme. Ce qui manque, c’est une orientation vers la collaboration entre humains et machines, plutôt que vers l’automatisation. Des modèles diversifiés, des lignes directrices solides de gouvernance et un débat engagé pourraient permettre beaucoup plus. L’ingrédient essentiel est le pouvoir d’agir humain. Le problème de fond à corriger est la réduction de ce pouvoir que nous avons inscrite dans la conception de nos machines.
Le cadre de gouvernance se met en place pour poser des garde-fous. Le dernier acteur à rallier est celui qui a réellement freiné la puissance de la technologie : l’industrie elle-même. Suite dans la partie III…
Notes
- La protection contre les acteurs malveillants mérite un article distinct, mais examiner les usages courants couvre, selon moi, une grande partie du problème. C’est comme la différence entre examiner les pays qui tolèrent les procédés industriels les plus polluants et ceux qui stimulent toute la demande pour leurs produits. ↩
- Ces discussions ont lieu aujourd’hui autour du règlement sur l’IA, mais la participation publique est essentielle à une correction de fond. Si cela vous intéresse, le National Institute of Standards and Technology (NIST), qui relève du département américain du Commerce, sollicite les commentaires du public. Au Canada, vous pouvez poser votre candidature au groupe canadien sur l’IA de l’Organisation internationale de normalisation ici[2]. ↩
Notes sur les références
- La source n’est plus accessible à son adresse d’origine.
https://nautil.us/blog/will-ai-harm-us-better-to-ask-how-well-reckon-with-our-hybrid-nature - La source n’est plus accessible à son adresse d’origine.
https://www.scc.ca/en/standards/committees/iso-iec-jtc-1-sc-42-artificial-intelligence
Merci de votre lecture.
Poursuivre la conversationPoursuivre la réflexion : Le pouvoir d’agir à l’ère de l’IA